У липні 2026 року OpenAI повідомила про 1 мільярд щотижневих користувачів ChatGPT. Для брендів це ще одна точка контакту з аудиторією: люди дедалі частіше використовують асистента для пошуку й порівняння товарів та послуг. І на те, чи з’явиться компанія в таких відповідях, можна впливати.
Чому ChatGPT рекомендує один бренд, а інший не згадує? Щоб відповісти на це питання, спершу варто зрозуміти, як саме він знаходить інформацію.
Як ChatGPT обирає бренди
Формування відповіді умовно можна розділити на чотири складники.
- Накопичені знання про бренд. Під час навчання модель обробляє великі масиви даних, а виявлені в них закономірності та зв’язки між брендами та продуктами закріплюються у вагах нейромережі. Тому компанії, які роками згадувались у Wikipedia, Reddit, медіа та інших відкритих джерелах, мають фору, але такі знання оновлюються не синхронно зі змінами на сайті.
- Query fan-out. Один промпт ChatGPT може перетворити на кілька пошукових запитів. За даними agentMention, у середньому — приблизно 2,5 запиту на один промпт. Система додає формулювання на кшталт best, top, comparison, reviews, а іноді й назви брендів, яких користувач не згадував.
- Пошук у різних типах джерел. ChatGPT може використовувати вебсторінки, новини, Wikipedia, YouTube, PDF та інші індекси. При цьому в пошуку може використовуватися кешована версія сторінки з власного індексу, тому оновлення сайту не завжди одразу змінює відповідь.
- Об’єднання та відбір результатів. Дані з різних підзапитів зводиться в єдиний рейтинг за допомогою методу RRF. Чим вище документ ранжується в кількох списках, тим більший його підсумковий бал.
Отже, з механікою вибору брендів для відповіді ми більш-менш розібралися. Саме час перейти до конкретних кроків.
Що робити, щоб опинитися серед брендів, які називає ChatGPT
1. Переконайтеся, що ChatGPT може прочитати ваш сайт
Перш ніж створювати новий контент, перевірте, чи доступний краулерам той, що вже існує. Сайт може мати гарний вигляд для людини, але бути закритим для бота або віддавати йому сторінку без основного вмісту.
- Почніть із розмежування ботів OpenAI. GPTBot використовується для навчання моделей, OAI-SearchBot — для пошуку в ChatGPT, а ChatGPT-User відкриває сторінки за запитом користувача. Тому в robots.txt важливо не заблокувати пошукового бота разом з усіма іншими. Моя рекомендація — дозволити ботам доступ до публічного контенту, залишивши закритими службові та приватні розділи.
- Окремо перевірте основний контент. Текст, ціни, характеристики й опис продукту мають бути видимими для краулера. Якщо вони завантажуються лише через JavaScript, попросіть розробника перевірити їхню доступність для ботів і за потреби налаштувати серверний рендеринг.
- Ще один важливий елемент — структуровані дані. Schema.org допомагає системі зрозуміти, де інформація про компанію, продукт і контент — наприклад, через Organization, Product, SoftwareApplication та Article.
2. Виміряйте, як ChatGPT бачить ваш бренд зараз
Щоб зрозуміти, чи допомагають зміни, потрібна точка відліку. Без неї через три місяці буде важко відрізнити результат роботи від звичайної мінливості відповідей.
Я б почав із набору з 30–50 промптів. Використовуйте не лише короткі ключові слова, а запитання, з якими люди справді можуть звернутися до асистента:
- Категорійні: Які сервіси email-розсилок підходять малому бізнесу?
- Пошук альтернатив: Які є аналоги X в Україні?
- Сценарні: Як автоматизувати збір відгуків після покупки?
Запити на кшталт “Що таке X і чим він відрізняється?” краще винести окремо: вони показують сприйняття бренду, але не його видимість у категорії. Формулювання можна брати зі звернень у підтримку, розмов із продажами та коментарів клієнтів.
Досліджуйте не лише відповідь, а й запити, які їй передували.
Fan-out показує, як модель інтерпретувала потребу користувача і що саме намагалася знайти.
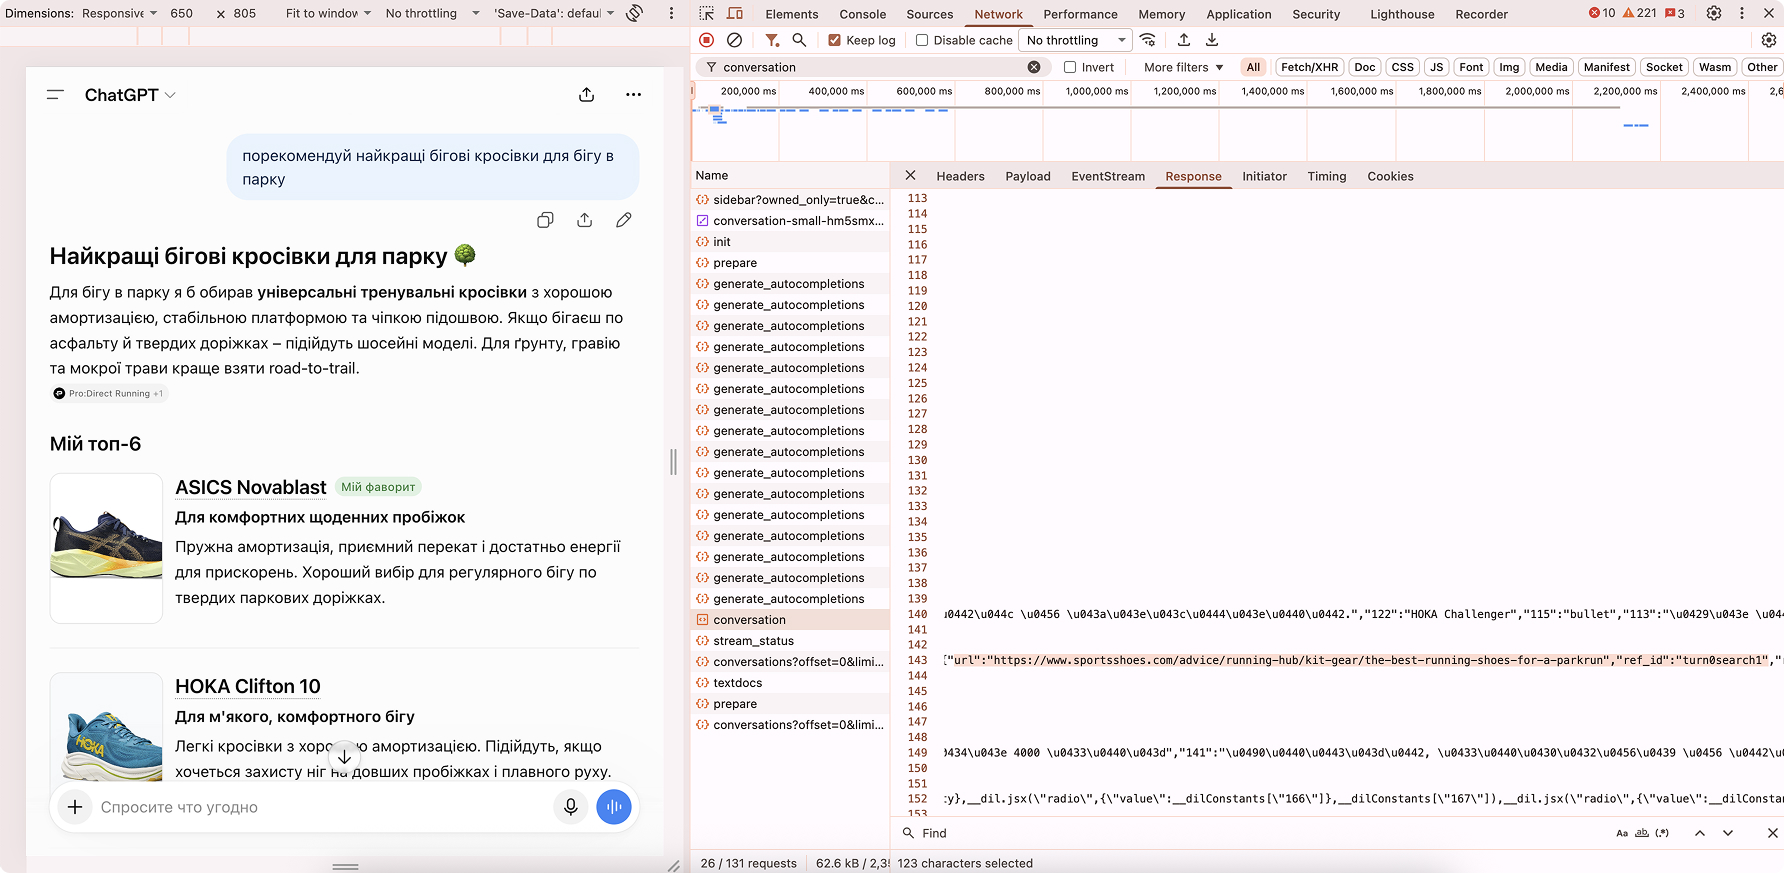
Якщо хочете перевірити власноруч, то можна подивитися, які саме пошукові запити ChatGPT формує під час вебпошуку. Для цього достатньо в браузері відкрити Chrome DevTools – там можна знайти службові виклики та побачити, як вихідний промпт перетворюється на конкретний search query.
У Chrome це можна перевірити через DevTools:
- Відкрийте Network і очистіть журнал запитів.
- Надішліть у ChatGPT промпт, який запускає вебпошук.
- Знайдіть мережевий запит, пов’язаний із поточною conversation.
- Відкрийте Response і виконайте пошук за web.run.
- Усередині виклику інструмента знайдіть пошукові запити — search або query.
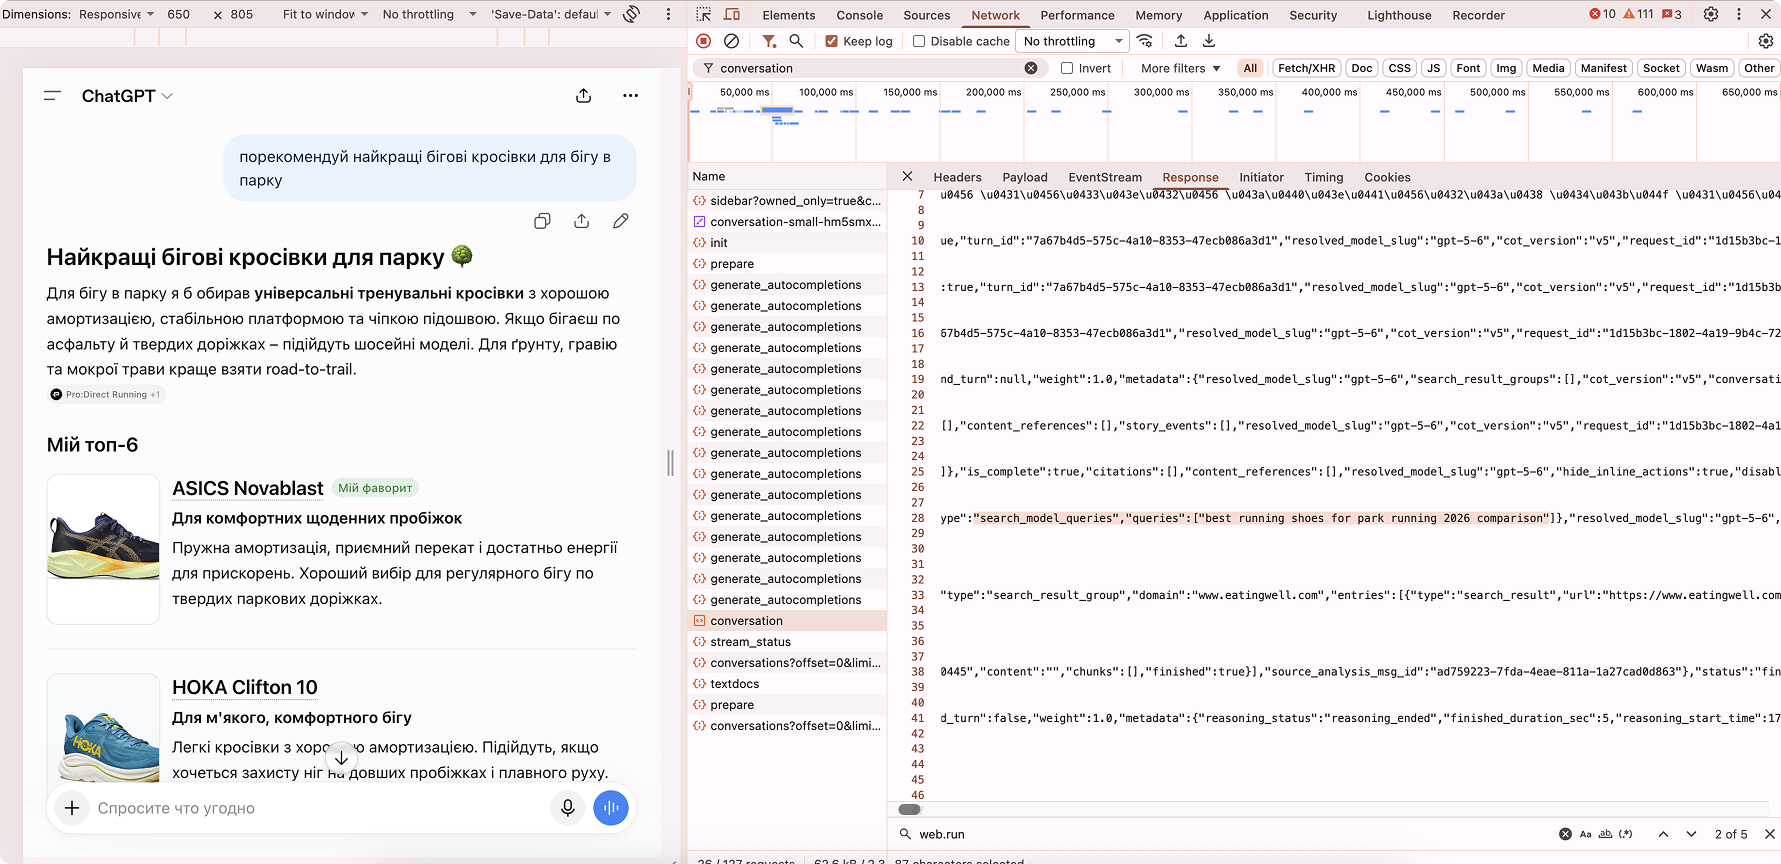
У наведеному прикладі поле search_model_queries показує, як промпт “порекомендуй найкращі бігові кросівки для бігу в парку” перетворився на “best running shoes for park running 2026 comparison”. Це вже конкретне формулювання, з яким можна працювати під час планування контенту.
Далі потрібні регулярні вимірювання. Той самий промпт у різних прогонах може дати різні списки брендів. Тому варто збирати відповіді регулярно, а висновки робити за накопиченою динамікою протягом місяця, не за одним вдалим або невдалим результатом.
Фіксуйте чотири речі:
- Чи згадано бренд
- Чи згадано його позицію
- Який тон опису
- Процитовані сторінки
Особливо уважно дивіться на джерела: вони підказують, де саме варто розвивати присутність. Додайте трьох найближчих конкурентів і порівнюйте частку згадок (share of voice), яка стабільніша за окрему позицію у списку.
Для 5–10 промптів таку роботу ще можна виконувати вручну. Для більшого набору є сенс використовувати платформи аналітики AI-пошуку, зокрема AgentMention, Peec AI або Profound, які збирають відповіді, відстежують видимість і витягують цитовані джерела та fan-out-запити.
3. Допоможіть моделі зрозуміти, до якої категорії належить ваш бренд
Уявімо, що на головній сторінці компанія називає себе “платформою для цифрової трансформації”, у LinkedIn — “CRM для B2B”, а на Clutch — “агенцією автоматизації”.
Ці описи створюють різні уявлення про один бізнес. Якщо категорія не визначена послідовно, моделі складніше включити бренд у відповідний список рекомендацій або додати його до fan-out-запиту як одного з лідерів.
Почніть з одного речення на 15–25 слів. Воно має пояснювати, що це за продукт, для кого він створений і яку задачу вирішує.
Наприклад, X — це сервіс обліку для ФОП і малого бізнесу в Україні, який автоматизує податкову звітність і виставлення рахунків.
Використовуйте це саме речення на головній сторінці, у розділі “Про нас”, у LinkedIn, Google Business Profile, каталогах і на маркетплейсах. Тут важлива послідовність, а не різноманітність формулювань. Потім перевірте решту публічної інформації про бренд.
Корисним доповненням стане сторінка “Що таке [бренд]” обсягом 300–500 слів. Почніть її з речення категорії, додайте розмітку Organization і посилання на офіційні профілі. Її завдання — бути канонічним джерелом опису бренду.
4. Розвивайте присутність там, звідки ChatGPT бере рекомендації
Після роботи з власним сайтом варто подивитися, які зовнішні джерела впливають на відповіді ChatGPT.
Подивіться, які домени ChatGPT уже знаходить і цитує за вашими цільовими промптами. Це можна побачити в тих самих даних пошуку, де й fan-out-запити.
Для SaaS це можуть бути G2, Capterra та галузеві порівняння. Для локального бізнесу TripAdvisor чи локальний і шопінг-індекси. В Україні перелік може включати DOU, Google Maps, галузеві медіа та україномовні YouTube-огляди, чи навіть LinkedIn. Точний набір має дати ваш аудит, а не загальна популярність платформи чи її DR.
Зверніть увагу на добірки “найкращі X для Y”. У чверті порадницьких fan-out-запитів ChatGPT сам додає слово «best». Знайдіть релевантні добірки й запропонуйте їхнім авторам щось корисне: свіжі дані, кейс із цифрами.
Так само системно працюйте з відгуками. “Reviews” — третє за частотою слово, яке ChatGPT додає до підзапитів, навіть коли користувач прямо не просить знайти відгуки.
Потрібно, щоб відгук містив контекст, задачу та результат. Саме про це варто просити розповісти клієнтів. І не обмежуйтеся найбільшими платформами: нішеві майданчики також входять до кола джерел, які агрегує ChatGPT.
Як початковий орієнтир я б розподіляв зусилля приблизно так: 70% на зовнішні джерела і 30% на власний контент.
5. Створюйте контент під реальні підзапити й давайте чіткі відповіді
Власний сайт залишається важливим. Але його варто розглядати не лише як вітрину, а як джерело відповідей на запити, які ChatGPT генерує під час пошуку.
Почніть із заголовків. “Огляд рішень для автоматизації складу” і “Найкращі WMS-системи для малого складу в Україні: порівняння 2026” можуть описувати близький матеріал. Але другий заголовок краще відповідає переформульованому пошуковому запиту. Тому під час планування статті варто дивитися не лише на початковий промпт, а й на його fan-out.
Далі подивіться на повноту матеріалу. Якщо сторінка відповідає одразу на кілька підзапитів — про найкращі рішення, порівняння та відгуки — вона може з’явитися в кількох списках результатів.
Я б обрав 30 глибоких матеріалів, які розкривають різні аспекти категорії, замість 200 розрізнених публікацій.
Давайте відповідь на початку розділу. Перші два речення під заголовком мають містити визначення, рекомендацію або цифру.
Для етапу вибору особливо корисні порівняння “X vs Y” та матеріали про альтернативи. Додайте таблицю з функціями, ціною, цільовою аудиторією.
Ще один напрям — оригінальні дані: опитування клієнтів або анонімізована статистика продукту. Разом із результатами вкажіть методологію, дату й вибірку.
Коли очікувати результату
Різні зміни працюють у різному часовому масштабі. Для технічних змін — відкриття доступу краулеру, появи нової сторінки, виправлення розмітки — орієнтиром є тижні. Для накопичення згадок на сторонніх майданчиках – два–чотири місяці. Зміни в знаннях, отриманих моделлю під час навчання, пов’язані з її наступними релізами; впливати на них можна лише опосередковано.
Саме тому вимірювання має супроводжувати роботу від початку. Щоденний збір даних і аналіз накопиченої динаміки допомагають не плутати затримку оновлення з відсутністю результату.
Читайте також